OOM 문제
최근 EC2 서버가 이유 없이 계속 다운되는 문제가 있었다.
처음에는 원인을 전혀 몰라서 이것저것 의심해봤는데, 시스템 로그를 보니 이렇게 찍혀 있었다.
Out of memory: Killed process 18908 (java) total-vm:2819548kB, anon-rss:314200kB, file-rss:0kB, shmem-rss:0kB, UID:0 pgtables:948kB oom_score_adj:0
OOM (Out Of Memory) 때문에 프로세스가 강제 종료된 것이다.
처음엔 내가 백그라운드 실행해 두었던 Slack 알림 셸 스크립트가 문제인 줄 알았지만, 로그를 자세히 들여다보니 문제의 진짜 원인은 우리 프로젝트였다. Java 프로세스가 메모리를 엄청 잡아먹고 있었다…
그래서 Dockerfile에서 JVM 메모리 옵션을 이렇게 조절해봤다.
ENTRYPOINT ["java", "-Xms256m", "-Xmx512m", "-XX:MetaspaceSize=128m", "-XX:MaxMetaspaceSize=256m", "-jar"]
JVM 메모리에 제한을 뒀었다. 하지만 그럼에도 해결이 되지 않았다.
도저히 원인을 모르겠어서 아버지의 도움을 받아봤다....
아마 “DB 커넥션 쪽 문제일 수도 있다”라고 하셨다.
실제로 커넥션을 열어놓고 제대로 닫지 않으면 메모리가 점점 먹히면서 이런 문제가 자주 생긴다고 하셨다.
생각해보니 전에 Hikari Pool starvation 관련해서 스레드가 멈추는 에러가 난 적이 있었다. 그래서 그와 관련된 키워드로 다시 찾아보기 시작했다.
처음엔 그냥 Spring의 application.yml에서 Hikari 설정을 만져주면 되는 줄 알았는데, Gemini에 물어보니 "Tomcat 스레드 수에 비해 Hikari max-pool 크기가 훨씬 작아야 한다"고 하더라.
이 부분은 따로 공부해서 정리할 예정!
https://codstudy.tistory.com/210
아무튼 기본 설정은 Tomcat 최대 스레드 200, Hikari pool max 10이라고 한다. 근데 솔직히 우리 서비스는 사용자도 거의 없는데 이 설정 때문에 문제가 생겼을 것 같지는 않다…
결국 근본적인 문제가 따로 있다는 느낌이 들었다.
DB 커넥션 풀 문제라면, 결국 코드 어딘가에서 커넥션을 제대로 반납하지 않는 지점이 있다는 뜻이다.
AI한테도 다시 물어보니까, @Transactional을 잘못 사용해서 커넥션이 블로킹된 상태로 유지될 가능성이 높다고 했다.
따라서 서비스 로직을 리펙토링 하여, 읽기 전용 트랜잭션에는 readOnly 설정을 주고, 트랜잭션 설정이 필요없는 로직은 transactional을 제거했다.
이렇게 리펙토링을 하여 서버를 다시 올렸는데도, 같은 문제가 반복됐다ㅜㅜ
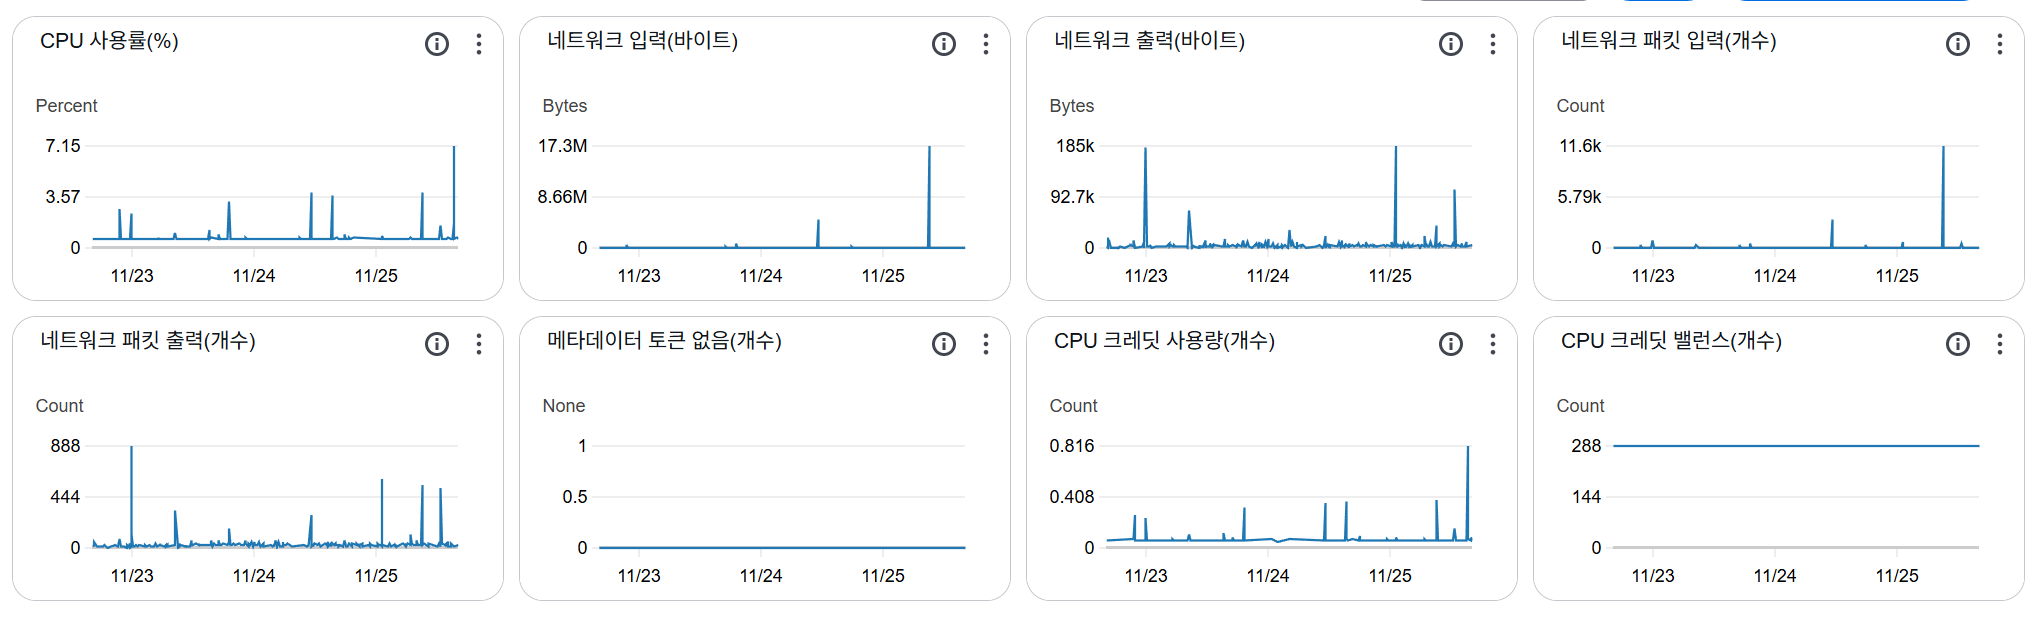
ec2 인스턴스 모니터링으로 들어가서 보니, 봇의 집중적인 요청 때문에 서버가 감당하지 못하고 다운된거였다. CPU 사용률이 급격히 치솟은 부분이 있었고, 이 때 메모리가 바닥나서 서버가 터졌던 것이다.
현재 인스턴스는 t3.micro로, ram이 1gb인데 이 메모리를 다 써버려서 서버가 터진 것이었다. 따라서 우선 swap 메모리를 2기가 정도 할당하였다.
그랬더니 계속 안정적으로 서버가 돌아간다!
인프라에 대해서 잘 모르는 채로 하다보니까 이런 문제가 생긴 것 같다. 앞으로 또 같은 문제가 생기지 않도록 공부를 좀 해야할 것 같다.